:::
特別報導
讓AI學會用水產研究的角度看資料
- 作者:嚴國維 / 海洋漁業組
本所海洋漁業組於115年8月24日邀請國立臺灣大學生物機電工程學系新進助理教授謝秉翰蒞所演講,以「人工智慧的歸納偏誤」為題,從影像辨識、機器人自主導航談到計算生物學,說明人工智慧如何從數值資料中建立判斷。演講中一個重要提醒是:模型從來不是中性地讀資料,研究者的假設其實早已寫進資料、模型與評估方法裡。
電腦是怎麼「看見」的?
一張油菜花田的照片,人只要看一眼,就知道哪裡是花、哪裡是葉、哪裡是土,也知道花長在葉子上方。同一張照片交給電腦,它拿到的卻只是一格一格的位置與顏色數值——沒有花,也沒有田。
既然電腦拿到的只是數值,要它認出油菜花,光給標好答案的照片還不夠。研究者還得決定三件事:用什麼數學方式把畫面轉成特徵、模型要輸出什麼形式的答案,以及用什麼標準衡量答案的誤差。
不同的做法,等於教模型用不同方式看畫面。卷積神經網路擅長從影像中擷取局部特徵,即使花朵換了位置,仍有機會辨識出來;視覺轉換器(Vision Transformer)則將影像切成小區塊,再透過注意力機制判斷不同區塊之間的關聯。若進一步將文字與影像對應,模型就能把「黃色」、「在中間」、「圓形」等描述與畫面中的物件連結,成為多模態應用的基礎。
自主導航也是類似的概念。GPS、陀螺儀與加速度計提供「我移動了多少」的資訊,影像、超音波或光達則提供「周圍是什麼樣子」的資訊;將兩者結合,機器才能推估障礙物距離與自身位置。
偏誤不一定是壞事
謝老師將常見問題分為四類。「資料偏誤」是訓練或評估資料在收集、處理或分布上存在系統性偏差,無法代表模型實際應用時會遇到的情況;「抽樣偏誤」來自抽樣方式,使部分資料被過度代表、另一些資料則嚴重不足;「評估偏誤」發生在評估資料、指標或流程與實際使用情境不一致;「測量偏誤」則來自儀器、方法或流程本身的系統誤差,使觀測值偏離真實情況。這些問題都可能讓模型在實驗環境中表現良好,換到新的場域卻失準,因此應設法辨識與修正。
「歸納偏誤」則不同。它不是資料品質問題,而是方法或實驗設計中所隱含的假設,決定模型「能看到哪些結論」,以及「偏好哪一類解法」。
沒有一種學習方法真正不帶假設。所謂「資料驅動」,也不是完全沒有假設,而是將假設放在資料表示方式、機率分布、目標函數與模型架構中,再讓模型從資料尋找符合這些條件的解。
因此,模型真正學會的,是數學設定所定義的問題,而不一定是研究者心裡真正想回答的科學問題。謝老師以基因功能與冰淇淋銷售為例說明:某個基因被剔除後,若有其他基因補償其功能,結果看起來「沒差」,並不能因此否定原本基因的功能;冰淇淋銷售量與溺水事件同時增加,也不能據此推論兩者存在因果關係。模型即使將目標函數最佳化得很好,也不代表它找到了自然界真正的因果關係。
也就是說,歸納偏誤不是越少越好。假設較強,搜尋範圍較小,資料有限時可能學得較快,但也可能在一開始就排除正確答案;假設較弱,雖然保留較多可能性,資料不足時卻容易過度擬合。真正重要的是,模型中的假設是否符合研究對象的科學特性,以及研究者是否清楚知道自己做了哪些假設。
模型架構也在表達假設
計算生物學可以進一步說明這件事。資料的特性會影響合理的表徵方式、機率分布與模型架構。
例如 DNA 序列由 ATCG 四個符號組成,功能性基序通常具有局部性,也可能出現在序列的不同位置,因此可使用卷積神經網路,隱含「局部特徵重要」及「位置改變不應影響功能判斷」等假設。若研究的是蛋白質交互作用,重點則從單一序列轉向由節點與連結構成的網絡,可使用圖神經網路,並考量「節點排列方式不應改變預測」及「連結本身具有生物意義」等特性。
因此,模型架構並不是單純的技術選擇。選擇卷積、注意力機制或圖神經網路,同時也代表研究者對資料結構與研究問題做出了不同判斷。模型架構是否適當,關鍵在於它所採用的假設是否與研究對象的特性相符
把研究知識放進模型
對水產研究而言,這些概念可以進一步轉化為具體的研究方法。
一、讓模型先認識生物結構
魚體影像不只是一張圖,而是具有頭、尾、體軸與一定比例的生物體。若能將這些先驗知識納入特徵設計,就不必完全依靠增加資料量來提升模型表現,也有助於提高體長、體型或健康狀態估測的準確度。
二、把時間資訊留給模型
如果將每一幀影像視為彼此獨立的畫面,模型就不知道那是同一尾魚連續游動的過程。加入物件追蹤與時間連續性,才能進一步分析魚類的移動軌跡、行為模式及對環境變化的反應。
三、讓模型符合物理與生物機制
將能量攝取、生物成長、流體力學或熱力學等已知關係納入模型限制條件,預測就不只是追求數值誤差最小,也必須符合已知的科學機制。對採樣成本高、樣本數有限的農漁業研究而言,將既有科學知識納入模型,有助於降低對大量資料的依賴。
回到漁業研究現場
綜合討論時,與會同仁提出幾項可能的應用,包括以影像量測取代反覆捕撈量測,減少對魚體的干擾;觀測離岸風機周邊的魚類行為;以及結合定點水質量測與大量浮游動物影像。若能進一步整合影像、位置、感測器與時間資訊,並將魚體形態、行為連續性與環境條件轉換為模型可以利用的結構,將有助於提高研究效率,也能降低現地採樣對生物及作業的干擾。
在漁海況預測方面,謝老師建議先釐清各項環境與漁獲資料的分布特性、零值的意義及異常值所代表的資訊,再決定是否轉為影像處理,或採用多因子模型。同一個突出數值,在異常偵測中可能是重要訊號,在去除雜訊時卻可能被視為干擾,因此資料處理方式必須配合研究目的。相較於只觀察單一變數,多來源、多因子的互補資訊通常更有助於支撐研究判斷。
現場也討論領域型 AI 助理的設計。通用語言模型的回答容易受到提問方式與使用者專業程度影響;若能先將不同問法轉換為標準化意圖,主動確認水域、水溫及養殖條件等必要資訊,再限定使用臺灣或特定研究計畫的可信資料作答,將有助於提高回答的一致性,降低資訊不足及模型產生錯誤資訊的風險。
從「用 AI」走向「用科學設計 AI」
這場演講帶來的啟發,不只是如何選擇更大的模型或蒐集更多資料,而是重新思考研究者的科學知識要如何進入 AI。從資料如何取得、如何表示,到模型如何建立、如何評估,每一個選擇都可能帶入研究者對生物、漁場與環境的理解。
對水試所而言,這也提供了一個重要方向:AI 不只是協助處理大量資料的工具,更可以成為科學推理的一部分。當研究假設、資料特性與生物機制被清楚納入模型,模型的預測結果才能回到研究問題本身加以檢驗。未來在魚類影像、浮游生物監測、漁海況預測及智慧漁業等研究上,如何讓 AI 不只「看見資料」,而是用水產研究的知識理解資料,將是值得持續探索的方向。
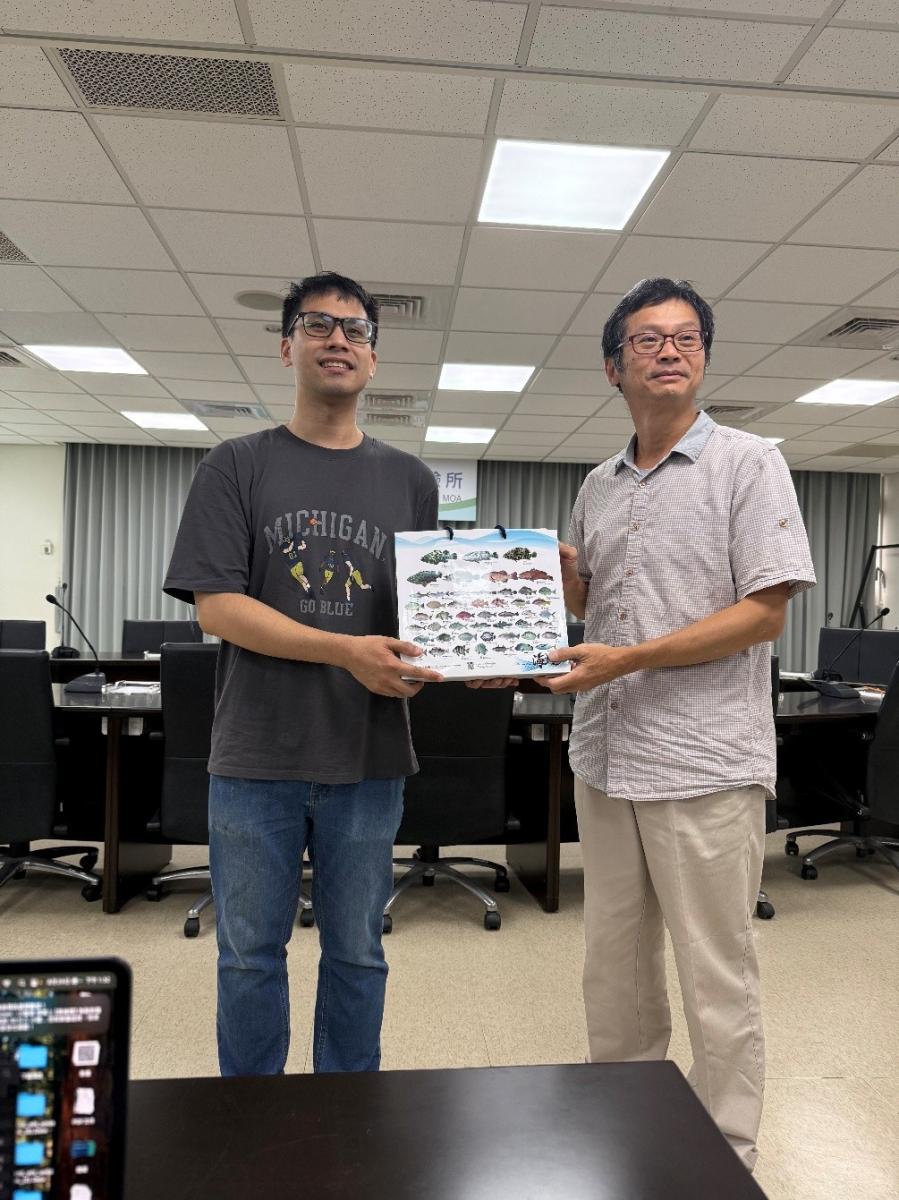
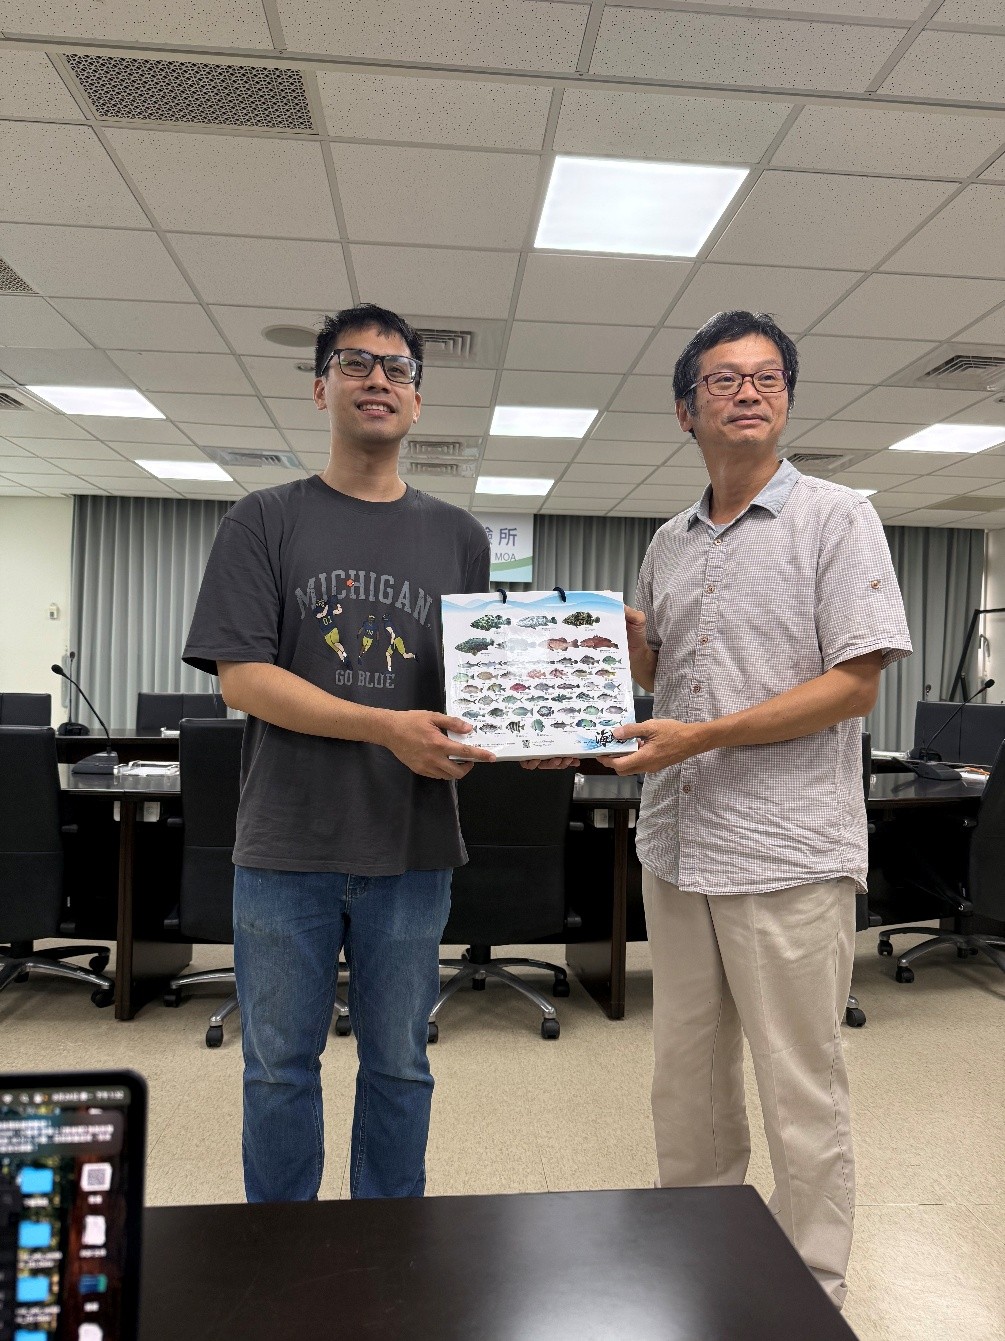
張可揚組長代表本所致贈宣導品,感謝謝秉翰老師的分享
電腦是怎麼「看見」的?
一張油菜花田的照片,人只要看一眼,就知道哪裡是花、哪裡是葉、哪裡是土,也知道花長在葉子上方。同一張照片交給電腦,它拿到的卻只是一格一格的位置與顏色數值——沒有花,也沒有田。
既然電腦拿到的只是數值,要它認出油菜花,光給標好答案的照片還不夠。研究者還得決定三件事:用什麼數學方式把畫面轉成特徵、模型要輸出什麼形式的答案,以及用什麼標準衡量答案的誤差。
不同的做法,等於教模型用不同方式看畫面。卷積神經網路擅長從影像中擷取局部特徵,即使花朵換了位置,仍有機會辨識出來;視覺轉換器(Vision Transformer)則將影像切成小區塊,再透過注意力機制判斷不同區塊之間的關聯。若進一步將文字與影像對應,模型就能把「黃色」、「在中間」、「圓形」等描述與畫面中的物件連結,成為多模態應用的基礎。
自主導航也是類似的概念。GPS、陀螺儀與加速度計提供「我移動了多少」的資訊,影像、超音波或光達則提供「周圍是什麼樣子」的資訊;將兩者結合,機器才能推估障礙物距離與自身位置。
偏誤不一定是壞事
謝老師將常見問題分為四類。「資料偏誤」是訓練或評估資料在收集、處理或分布上存在系統性偏差,無法代表模型實際應用時會遇到的情況;「抽樣偏誤」來自抽樣方式,使部分資料被過度代表、另一些資料則嚴重不足;「評估偏誤」發生在評估資料、指標或流程與實際使用情境不一致;「測量偏誤」則來自儀器、方法或流程本身的系統誤差,使觀測值偏離真實情況。這些問題都可能讓模型在實驗環境中表現良好,換到新的場域卻失準,因此應設法辨識與修正。
「歸納偏誤」則不同。它不是資料品質問題,而是方法或實驗設計中所隱含的假設,決定模型「能看到哪些結論」,以及「偏好哪一類解法」。
沒有一種學習方法真正不帶假設。所謂「資料驅動」,也不是完全沒有假設,而是將假設放在資料表示方式、機率分布、目標函數與模型架構中,再讓模型從資料尋找符合這些條件的解。
因此,模型真正學會的,是數學設定所定義的問題,而不一定是研究者心裡真正想回答的科學問題。謝老師以基因功能與冰淇淋銷售為例說明:某個基因被剔除後,若有其他基因補償其功能,結果看起來「沒差」,並不能因此否定原本基因的功能;冰淇淋銷售量與溺水事件同時增加,也不能據此推論兩者存在因果關係。模型即使將目標函數最佳化得很好,也不代表它找到了自然界真正的因果關係。
也就是說,歸納偏誤不是越少越好。假設較強,搜尋範圍較小,資料有限時可能學得較快,但也可能在一開始就排除正確答案;假設較弱,雖然保留較多可能性,資料不足時卻容易過度擬合。真正重要的是,模型中的假設是否符合研究對象的科學特性,以及研究者是否清楚知道自己做了哪些假設。
模型架構也在表達假設
計算生物學可以進一步說明這件事。資料的特性會影響合理的表徵方式、機率分布與模型架構。
例如 DNA 序列由 ATCG 四個符號組成,功能性基序通常具有局部性,也可能出現在序列的不同位置,因此可使用卷積神經網路,隱含「局部特徵重要」及「位置改變不應影響功能判斷」等假設。若研究的是蛋白質交互作用,重點則從單一序列轉向由節點與連結構成的網絡,可使用圖神經網路,並考量「節點排列方式不應改變預測」及「連結本身具有生物意義」等特性。
因此,模型架構並不是單純的技術選擇。選擇卷積、注意力機制或圖神經網路,同時也代表研究者對資料結構與研究問題做出了不同判斷。模型架構是否適當,關鍵在於它所採用的假設是否與研究對象的特性相符
把研究知識放進模型
對水產研究而言,這些概念可以進一步轉化為具體的研究方法。
一、讓模型先認識生物結構
魚體影像不只是一張圖,而是具有頭、尾、體軸與一定比例的生物體。若能將這些先驗知識納入特徵設計,就不必完全依靠增加資料量來提升模型表現,也有助於提高體長、體型或健康狀態估測的準確度。
二、把時間資訊留給模型
如果將每一幀影像視為彼此獨立的畫面,模型就不知道那是同一尾魚連續游動的過程。加入物件追蹤與時間連續性,才能進一步分析魚類的移動軌跡、行為模式及對環境變化的反應。
三、讓模型符合物理與生物機制
將能量攝取、生物成長、流體力學或熱力學等已知關係納入模型限制條件,預測就不只是追求數值誤差最小,也必須符合已知的科學機制。對採樣成本高、樣本數有限的農漁業研究而言,將既有科學知識納入模型,有助於降低對大量資料的依賴。
回到漁業研究現場
綜合討論時,與會同仁提出幾項可能的應用,包括以影像量測取代反覆捕撈量測,減少對魚體的干擾;觀測離岸風機周邊的魚類行為;以及結合定點水質量測與大量浮游動物影像。若能進一步整合影像、位置、感測器與時間資訊,並將魚體形態、行為連續性與環境條件轉換為模型可以利用的結構,將有助於提高研究效率,也能降低現地採樣對生物及作業的干擾。
在漁海況預測方面,謝老師建議先釐清各項環境與漁獲資料的分布特性、零值的意義及異常值所代表的資訊,再決定是否轉為影像處理,或採用多因子模型。同一個突出數值,在異常偵測中可能是重要訊號,在去除雜訊時卻可能被視為干擾,因此資料處理方式必須配合研究目的。相較於只觀察單一變數,多來源、多因子的互補資訊通常更有助於支撐研究判斷。
現場也討論領域型 AI 助理的設計。通用語言模型的回答容易受到提問方式與使用者專業程度影響;若能先將不同問法轉換為標準化意圖,主動確認水域、水溫及養殖條件等必要資訊,再限定使用臺灣或特定研究計畫的可信資料作答,將有助於提高回答的一致性,降低資訊不足及模型產生錯誤資訊的風險。
從「用 AI」走向「用科學設計 AI」
這場演講帶來的啟發,不只是如何選擇更大的模型或蒐集更多資料,而是重新思考研究者的科學知識要如何進入 AI。從資料如何取得、如何表示,到模型如何建立、如何評估,每一個選擇都可能帶入研究者對生物、漁場與環境的理解。
對水試所而言,這也提供了一個重要方向:AI 不只是協助處理大量資料的工具,更可以成為科學推理的一部分。當研究假設、資料特性與生物機制被清楚納入模型,模型的預測結果才能回到研究問題本身加以檢驗。未來在魚類影像、浮游生物監測、漁海況預測及智慧漁業等研究上,如何讓 AI 不只「看見資料」,而是用水產研究的知識理解資料,將是值得持續探索的方向。
張可揚組長代表本所致贈宣導品,感謝謝秉翰老師的分享
- 相關圖片
-